






Wichtige Erkenntnisse
- Die Genauigkeit der Bewertung wird durch die kombinierten Bleibewertungsdaten bestimmt, nicht durch den Algorithmus.
- Widersprüchliche CRM- und Plattformfelder verfälschen stillschweigend alle nachfolgenden Ergebnisse.
- Das Lead-Scoring im Zeitalter der KI erbt Datenprobleme, es löst sie nie.
- Doppelte Kontaktdatensätze führen zu einer Aufteilung des Verhaltenssignals auf zwei Klassenstufen.
- Vor der Bewertung müssen Qualitätskontrollen der Bleigraddaten durchgeführt werden.
- Eine dokumentierte Mischungsprüfung sichert das Vertrauen des Vertriebs in die Bewertung.
Inhaltsverzeichnis
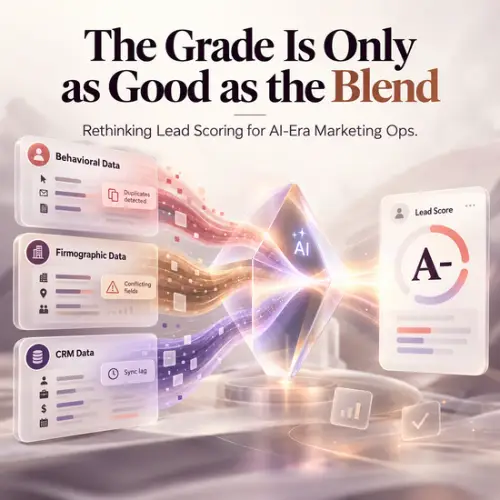
Ein Lead-Scoring-Modell kann auf dem Dashboard einwandfrei erscheinen und dennoch für jeden einzelnen Account, den es erfasst, fehlerhaft sein. Der Fehler liegt selten im Algorithmus selbst, sondern in den zusammengewürfelten Lead-Scoring-Daten, die ihm zugeführt werden: Webverhalten, das in einem System erfasst wird, firmografische Felder aus einem anderen und CRM-Datensätze, die seit zwei Jahren nicht mehr dedupliziert wurden.
Marketing-Operations-Teams stehen unter Druck, Lead-Scoring im KI-Zeitalter auf bestehende Systeme aufzuspielen und erwarten, dass das Modell Lücken schließt, die die zugrundeliegenden Daten nie geschlossen haben. KI gleicht jedoch weder einen Salesforce-Kontaktdatensatz mit einem Eloqua-Profilfeld ab, noch entscheidet sie, welche von drei widersprüchlichen Berufsbezeichnungen in einem einzelnen Account die aktuelle ist.
Die zugrunde liegenden Lead-Scoring-Daten, nicht die darüberliegende Scoring-Logik, entscheiden darüber, ob der Vertrieb dem Rating genügend Vertrauen schenkt, um darauf zu reagieren. Die eigentliche Arbeit beginnt hier, indem diese Daten optimiert und entsprechende Prüfungen in den Arbeitsablauf integriert werden. Einen umfassenderen Überblick darüber, wie KI Scoring und Grading verändert, finden Sie in unserem Artikel „ Wie KI Lead-Scoring und -Grading für Marketing Operations revolutioniert“.
Was bedeuten „gemischte“ Lead-Scoring-Daten eigentlich?
Die kombinierten Lead-Scoring-Daten – eine Mischung aus Verhaltens-, Firmen- und CRM-Signalen – werden von einem Scoring-Modell als ein einziges Profil behandelt, selbst wenn drei verschiedene Systeme unterschiedliche Daten liefern. Die meisten Lead-Scoring-Modelle greifen gleichzeitig auf drei Datenquellen zu, und die kombinierten Daten werden selten als Einheit geprüft.
Die drei Schichten, die üblicherweise in der Mischung enthalten sind
Verhaltensebene: E-Mail-Öffnungen, Formularausfüllungen und Seitenbesuche werden nativ in Eloqua oder Marketo erfasst.
Firmografische Ebene: Unternehmensgröße, Branche und Umsatzklasse, in der Regel aus einem separaten Anreicherungstool extrahiert.
CRM-Ebene: Opportunity-Phase, Account-Zuständigkeit und Deal-Historie, typischerweise in Salesforce oder Dynamics gespeichert.
Wie gut diese Ebenen tatsächlich miteinander kommunizieren, und nicht nur wie viele es sind, entscheidet über Erfolg oder Misserfolg der Integration. „Eloqua CRM-Integration: 7 Vorteile, die im KI-Zeitalter noch stärker wirken“ beschreibt die Synchronisierungsmuster, die zuerst überprüft werden sollten.
Warum die Mischung schon vor dem Eingreifen der KI scheitert
Die meisten Daten aus kombinierten Lead-Scoring-Systemen scheitern an den Schnittstellen zwischen den Systemen, nicht innerhalb eines einzelnen Systems. Doppelte Kontaktdatensätze, veraltete Feldwerte und widersprüchliche Berufsbezeichnungen verfälschen die Datenmischung lange bevor ein Scoring-Modell überhaupt ausgeführt wird.
Das Problem der doppelten Datensätze
Ein Lead-Score, der auf doppelten Kontaktdatensätzen basiert, ist nicht nur einmal, sondern gleich zweimal falsch: einmal für jede Kopie derselben Person, die das System separat erfasst. Das Verhaltenssignal verteilt sich auf beide Datensätze, sodass keiner von ihnen das tatsächliche Engagement des Accounts widerspiegelt. Die Salesforce-Hilfe erklärt unter „Wissenswertes zu Duplikatregeln“, wie Duplikatregeln die Übereinstimmungskriterien auswerten. Es empfiehlt sich, dies zu überprüfen, bevor Sie davon ausgehen, dass Ihr CRM diese automatisch erkennt.
Das Problem der Synchronisierungsverzögerung
Wenn Feldwerte im CRM aktualisiert werden, aber in Eloqua oder Marketo hinterherhinken (oder umgekehrt), wird die Bewertung anhand des gestrigen Kontos und nicht anhand des heutigen berechnet. Der Artikel „ Warum Datenqualität im RevOps-Prozess die Zukunft der Umsatzentwicklung bestimmt“ erläutert, wie sich Synchronisierungsverzögerungen in einem Umsatzteam, das dieselben Datensätze verwendet, verstärken.
Teams, die diesen Schritt überspringen, bemerken ihn meist erst, nachdem sie KI hinzugefügt haben. Genau dieses Fehlermuster wird in „ Warum KI-Marketing-Pilotprojekte scheitern: Die fehlende Grundlage für Datenhygiene“ dokumentiert.
Wie KI die Anforderungen an die Datenqualität verändert
Es erhöht die Kosten einer fehlerhaften Mischung, anstatt sie zu senken. Ein Modell, das mehr Eingangsgrößen gewichtet und häufiger aktualisiert wird, verarbeitet eine fehlerhafte Mischung einfach schneller und mit scheinbar größerer Überzeugung von dem falschen Ergebnis.
Hierbei handelt es sich um ein KI-gestütztes Scoring, das auf den bereits in Eloqua, Marketo und dem CRM vorhandenen Daten des Marketing-Operations-Teams aufbaut. Es ist kein vollständig prädiktives, autonomes Machine-Learning-Modell, das die Bewertung selbstständig trifft. Die Kombination der Daten muss weiterhin stimmen, da die KI nur Daten auswertet, die von den zugrunde liegenden Systemen bereits erfasst wurden.
Die Vor- und Nachteile der KI-gestützten Ebene gegenüber einem einfachen regelbasierten Modell werden in „KI-gestütztes Lead-Scoring vs. regelbasiertes Scoring: Was jedes B2B-MOPs-Team wissen muss“ erläutert . Kurz gesagt: Beide Ansätze verzeihen keine ungenaue Datenmischung. Selbst eine vollständig abgestimmte Mischung ist keine dauerhafte Lösung: Die Punktwerte guter Daten können mit der Zeit veralten – ein Problem, das im Abschnitt „ Drift des Scoring-Modells“ behandelt wird.
Wo Marketo- und Eloqua-Teams dies zuerst sehen
Marketo-Teams, die KI-gestützte Gewichtung in ein bestehendes punktbasiertes Modell integrieren, erkennen Probleme mit der Datenmischung in der Regel am schnellsten, da das Modell widersprüchliche Bewertungen für Accounts liefert, die eigentlich zusammengehören sollten. „Marketo Lead Scoring: Ein praxiserprobtes Framework für B2B-Teams“ stellt eine Bewertungsstruktur vor, die genau solche Abweichungen frühzeitig erkennt.
Auf der Eloqua-Seite dient der Leitfaden des Oracle Eloqua Help Centers zur Konfiguration von Profilkriterien als Referenzpunkt, um zu bestätigen, welche Felder tatsächlich in die Bewertung einfließen, bevor eine KI-gestützte Gewichtung hinzugefügt wird.
Welche Qualitätsprüfungen von Bleibewertungsdaten sollten Sie durchführen, bevor Sie einem Ergebnis vertrauen?
Führen Sie regelmäßig Qualitätsprüfungen dieser Mischung durch, nicht nur dann, wenn sich der Vertrieb über einen ungeeigneten Lead beschwert. Vier Prüfungen decken die meisten Fehler in der Mischung auf, bevor sie die Warteschlange eines Vertriebsmitarbeiters erreichen.
Feldzuordnungsprüfung: Prüfen Sie, welches CRM-Feld welchem Eloqua- oder Marketo-Feld zugeordnet ist, und kennzeichnen Sie alle Felder, die Daten aus mehr als einer Quelle abrufen, ohne dass eine Priorität definiert ist.
Duplikatauflösungszyklus: Richten Sie einen wiederkehrenden Zusammenführungszyklus ein, anstatt einer einmaligen Bereinigung, damit sich doppelte Kontaktdatensätze nicht unbemerkt wieder ansammeln.
Hierarchie der Wahrheitsquellen: Dokumentieren Sie, welches System Vorrang hat, wenn zwei Quellen hinsichtlich desselben Datenpunkts nicht übereinstimmen, bevor das Bewertungsmodell raten muss.
Überprüfungsrhythmus der Bewertung: Jeden Monat eine Stichprobe der bewerteten Konten ziehen und vom Vertrieb bestätigen lassen, dass die Bewertung mit der eigenen Einschätzung des Kontos übereinstimmt.
Die Marketing-Automatisierungsprüfung: 5 kritische Gesundheitsfaktoren, die Führungskräfte übersehen, ist eine nützliche Checkliste für den Einstieg, falls eine solche Überprüfung Ihrer Datenbank in den letzten zwei Quartalen nicht stattgefunden hat.
Fazit
Die von einem Scoring-Modell generierte Bewertung ist nur so zuverlässig wie die zugrunde liegenden Lead-Scoring-Daten. Auch ausgefeilte KI ändert daran nichts. Marketing-Teams, die die Datenbasis als Teil ihrer Infrastruktur betrachten und regelmäßig prüfen, erkennen Abweichungen in der Bewertung, bevor sie den Vertrieb erreichen. Teams, die KI als Allheilmittel einsetzen, bewerten dieselben fehlerhaften Daten schneller und mit größerer Sicherheit als mit dem falschen Ergebnis. Beginnen Sie mit der Feldzuordnung und der regelmäßigen Duplikatsbereinigung, nicht mit dem Scoring-Modell selbst. So hält die Bewertung einer kritischen Prüfung stand. Wenn Ihr Team die Datenqualität Ihrer aktuellen Bewertungen von einer zweiten Person überprüfen lassen möchte, wenden Sie sich an 4Thought Marketing.
Über 4Thought Marketing
Wir sind eine B2B-Marketingautomatisierungs- und KI-Beratung mit dem Ziel, komplexe Technologien erfolgreich umzusetzen. Seit 2008 unterstützen wir Hunderte von Unternehmen aus den Bereichen Finanzdienstleistungen, Technologie, Fertigung und Immobilien dabei, mehr aus Eloqua, Marketo und deren CRM-Integrationen herauszuholen. Wir beraten unsere Kunden in den Bereichen Marketingautomatisierungsstrategie, Lead-Lifecycle-Management, KI, Compliance, Präferenzmanagement und mehr. Entdecken Sie unsere Dienstleistungen or Nimm Kontakt mit uns auf.
Häufig gestellte Fragen
Was sind kombinierte Lead-Scoring-Daten?
Die kombinierten Lead-Scoring-Daten – Verhaltens-, Firmen- und CRM-Signale – werden von einem Scoring-Modell als ein einziges Profil behandelt, obwohl sie aus unterschiedlichen Systemen wie Eloqua oder Marketo, einem Anreicherungstool und einem CRM stammen. Die Qualität dieser Kombination, nicht die Scoring-Formel, bestimmt die Vertrauenswürdigkeit der resultierenden Bewertung.
Kann KI eine fehlerhafte Lead-Scoring-Mischung selbstständig korrigieren?
Nein. KI-gestütztes Scoring verarbeitet zwar die im Datensatz enthaltenen Daten schneller und scheinbar zuverlässiger, gleicht aber weder doppelte Datensätze ab, noch löst es widersprüchliche Feldwerte auf oder behebt Synchronisierungsverzögerungen zwischen Systemen. Diese Datenqualitätsprobleme müssen an der Quelle gelöst werden, bevor KI-gestütztes Lead-Scoring einen echten Mehrwert bietet.
Wie wirken sich doppelte Kontaktdatensätze auf die Lead-Bewertung aus?
Doppelte Datensätze verteilen das Verhaltenssignal eines Accounts auf zwei oder mehr Einträge, sodass keiner der Datensätze das tatsächliche Engagement des Accounts widerspiegelt. Dies führt zu inkonsistenten Bewertungen für einen eigentlich einzelnen Account und ist eine der häufigsten Ursachen für einen Lead-Score, dem der Vertrieb nicht vertraut.
Wie oft sollte ein Marketing-Operations-Team die Qualität der Lead-Bewertungsdaten überprüfen?
Die Feldzuordnung und die Duplikatsbereinigung sollten regelmäßig, idealerweise monatlich, und nicht als einmaliges Projekt durchgeführt werden. Eine vierteljährliche Bewertungsprüfung, bei der der Vertrieb eine Stichprobe der Bewertungen mit seiner eigenen Einschätzung des Kontos abgleicht, deckt Abweichungen auf, die automatisierte Prüfungen nicht erfassen.
Was ist eine Quellenhierarchie beim Lead-Scoring?
Es gibt eine dokumentierte Regel, welches System Vorrang hat, wenn zwei Datenquellen im selben Feld, wie z. B. Berufsbezeichnung oder Unternehmensgröße, voneinander abweichen. Ohne eine solche Regel muss das Bewertungsmodell oder das Team, das die Konflikte löst, raten, was zu Inkonsistenzen in allen nachfolgenden Bewertungen führt.
Gilt dies sowohl für Eloqua- als auch für Marketo-Umgebungen?
Ja. Beide Plattformen fließen Verhaltensdaten zusammen mit CRM- und Anreicherungsdaten in eine kombinierte Bewertung ein und sind denselben Risiken durch doppelte Datensätze und Synchronisierungsverzögerungen ausgesetzt. Die Feldnamen unterscheiden sich (Eloqua-Profilkriterien versus Marketo-Bewertungsregeln), die zugrunde liegende Datenqualitätssicherung ist jedoch identisch.